How to use seastar105/pocket-tts-korean-100m with Pocket-TTS:
from pocket_tts import TTSModel
import scipy.io.wavfile

tts_model = TTSModel.load_model("seastar105/pocket-tts-korean-100m")
voice_state = tts_model.get_state_for_audio_prompt(
    "hf://kyutai/tts-voices/alba-mackenna/casual.wav"
)
audio = tts_model.generate_audio(voice_state, "Hello world, this is a test.")
# Audio is a 1D torch tensor containing PCM data.
scipy.io.wavfile.write("output.wav", tts_model.sample_rate, audio.numpy())
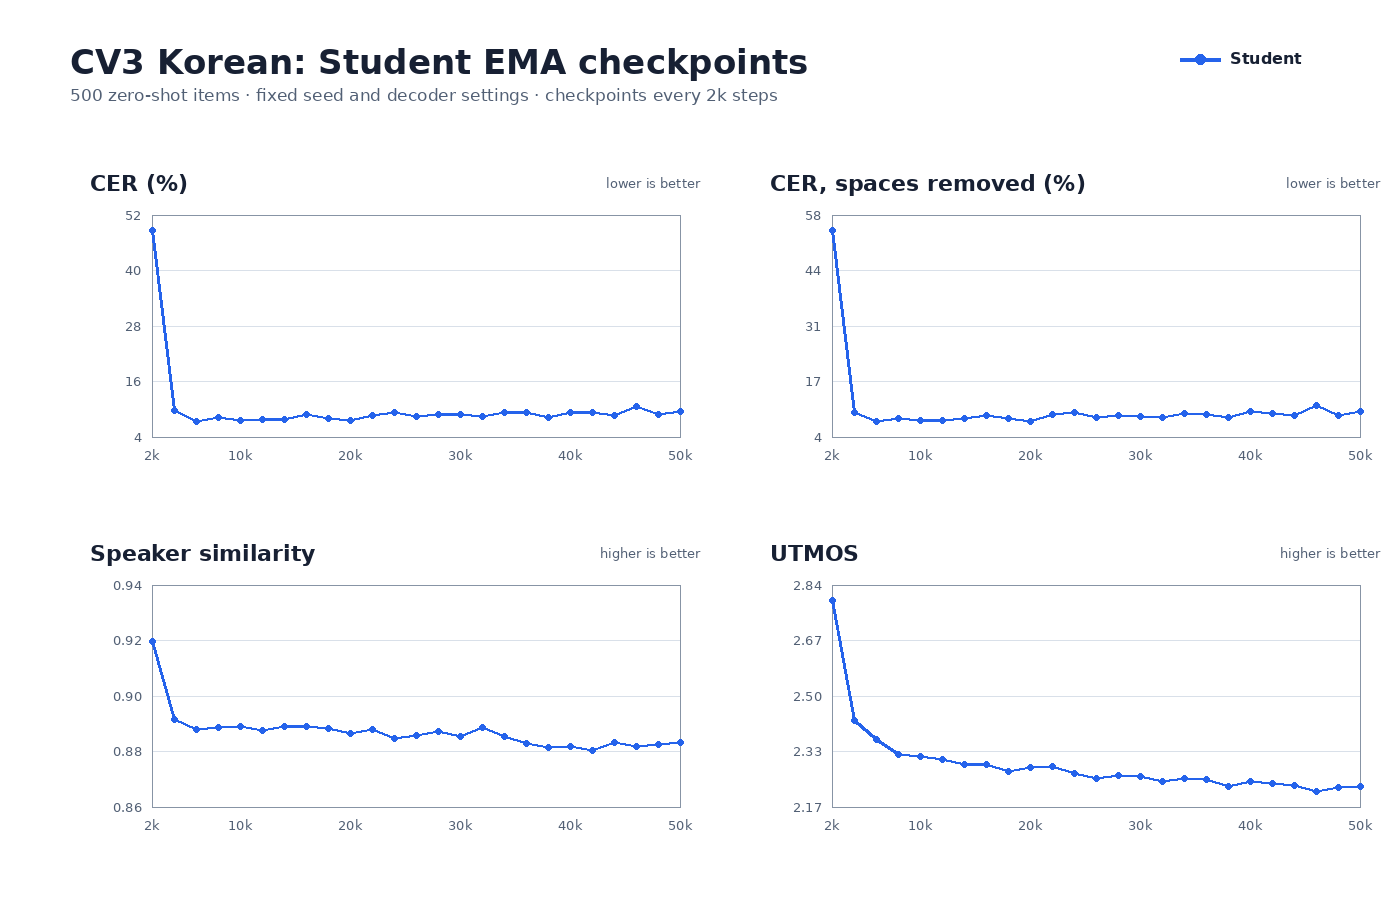
https://huggingface.co/seastar105/pocket-tts-korean-100m/resolve/main/assets/cv3_ema_sweep.png
hf download hf://seastar105/pocket-tts-korean-100m/assets/cv3_ema_sweep.png
curl -L -o cv3_ema_sweep.png https://huggingface.co/seastar105/pocket-tts-korean-100m/resolve/main/assets/cv3_ema_sweep.png